什么是道德测试?理解其中的问题、方法与边界
作者:Julian Croft · 更新于 2026 年 11 月 3 日
道德测试是一个宽泛的说法,指的是围绕道德判断、价值观或选择设计出来的问卷或练习。这个名字并不指向某一套标准化的工具。在解读任何一个结果之前,先问清楚三件事:这个具体的工具问了什么?它如何处理你的作答?又有哪些证据支撑它的说法?
本网站的道德反思工具就是其中之一。在解读结果之前,不妨先把它实际的形式和其他类型的任务比一比。它并不把结果当成品格证书、临床评估,或者所有伦理困境的答案。
道德问题关乎的是理由、利益与义务
道德问题问的是"应该怎么做,以及为什么",其中包括人们会受到怎样的影响、有哪些义务适用。"我该不该纠正一个对我有利的错误?"就是这样一个例子。而"我更倾向于哪个选项?"只有当这种偏好影响到别人的利益时,才可能变成一个道德问题。
测试可能会让你同意某个陈述、在若干选项中做出选择,或者对某个虚构行为作出判断。这些任务测量的东西并不一样。在一个设定好的假设情境里选择答案,和在真实处境中一边信息不全、一边还要承担后果地行动,更是两回事。
请始终牢记这一区别。一个经过深思熟虑的答案是可以拿出来讨论的,但它并不能证明你届时会怎么做。同样,仅仅因为你不同意某份问卷的措辞,并不能说明你缺乏道德罗盘。
先分清反思类工具,再比较结果
判断这类工具时,请按"它要求你做什么"来区分。
| 练习类型 | 你要做什么 | 解读之前该问的问题 |
|---|---|---|
| 同意度问卷 | 针对有关价值观或判断的陈述做出回应 | 具体计分的是什么?分数更高又意味着什么? |
| 伦理困境练习 | 在虚构情境中作出判断或选择 | 哪些设定是固定的?哪些信息是缺失的? |
| 价值观工作表 | 用你自己的话描述优先级和具体例子 | 它是一个讨论辅助工具,还是一套有验证证据的测量工具? |
| 虚构作品契合度测验 | 探索一个故事里的分类归属 | 这个结果是否被误当成了对现实中个人品格的评估? |
举个例子,一个困境题可能会问:在付出代价打破既定流程的情况下,你是否应该帮朋友。而一份陈述式问卷问的可能是:你在多大程度上认同某项义务。即使两者都涉及公平,它们的分数也不能自动放在一起比较。
Cushman 等人研究中的 Moral Sense Test 是一项在线的哈佛情境任务:参与者要评判的是假设中的行为或不作为,而不是对价值陈述作出回应。他们的判断,与事后能够说清楚的原则,并不总是彼此吻合 [1]。
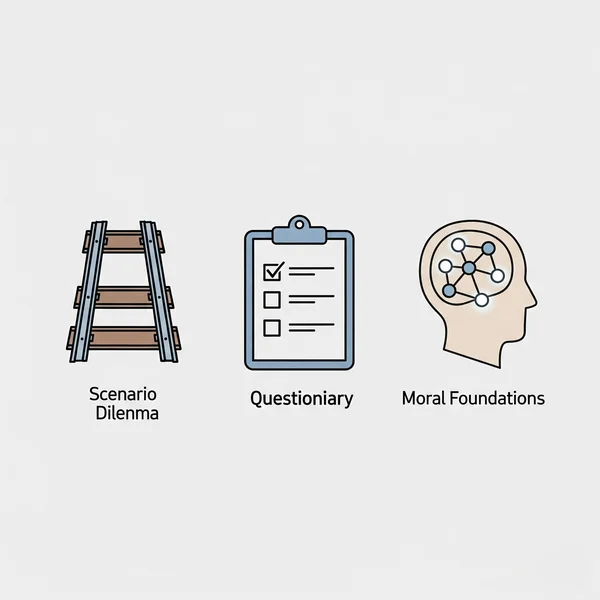
道德心理学研究能贡献什么
Graham 等人的工作描述了一套用于研究道德关切的道德基础框架,以及配套的问卷。该框架包含伤害/关怀、公平/互惠、内群体/忠诚、权威/尊重,以及纯洁/神圣。Atari 等人后来的研究则采用了另一种基础结构。用的是哪一个测量版本,确实很重要。[2,3]
这些研究工具不应该被揉捏成"所有道德测试都准确"这样的笼统说法。一个经过改编的网站问卷,需要为自己的用途提供证据。引用一套已经发表的理论,并不能证明某个网站的分数可以预测行为、揭示隐藏动机,或者为某个人挑出"正确的"伦理哲学。
哲学层面的反思问的是另一个问题。你可以追问后果、义务,或者你想成为什么样的人,而无需声称一份问卷把你归进了某个哲学学派。即使最后没有得出一个数字,这类问题依然有价值。
为什么困境题的答案和价值观分数会不一样
困境题把一部分事实设定好,让你评判某个选择;价值观问卷问的是你有多认同某条陈述或某个优先事项。这两类任务主题上可能重叠,产出的证据类型却不同。Ni 等人的一项综述梳理了多种自我报告和困境式测量方法,并没有哪一套工具能充当道德决策的通用标准。[4]
设想一个关于"违背承诺以阻止伤害"的虚构问题。回答"是"留下了好几个可能:也许那个伤害很严重,也许这个承诺本身是被迫的,也许有另一项义务更优先。只改动其中一个条件,同一个人可能就会给出不同的答案。这个答案本身,并不能揭示一套恒定的哲学立场。
Kahane 认为,那些常被贴上功利主义标签的牺牲式困境,并不能确立一个人对功利主义的认同。[5] 在一个人为构造的场景里选择"救更多人",可能出于好几个寻常原因,而不是对整套伦理理论的背书。如果某个测验给你安上了一个哲学标签,请先看看它实际设置的任务是什么,再决定是否接受这种解读。
不妨同时问两个问题:"你选了什么?"以及"是哪个细节改变了你的答案?"把判断和它的理由一起拿出来讨论,能让你审视的东西远比一个通过与否的分数多。
Defining Issues Test(DIT)让读者对困境故事中的各种理由评分并排序;它的 P 分关注的是对后习俗推理的认可程度。DIT-2 对任务做了更新,使用 N2 指标,同时也考虑了"拒绝较不成熟的推理方式"这一点 [4]。这些任务关注的是关于道德推理的某一种特定说法,而不是关于良好品格的通用刻度。
Schwartz 的价值观框架关注的则是目标之间的相对重要性 [7]。一份道德基础问卷问的是你所认同的道德关切,而困境任务要求你在一组设定之内作出判断。请选择与你的问题相匹配的任务,并让每个结果始终依附于它自己的那套工具。
本站的问卷是怎么运作的
站点给出 48 条陈述,配 7 级量表的选项,从非常同意一路排到非常不同意。在实现方式上,这些题目被归入关怀/伤害、公平/欺骗、忠诚/背叛、权威/颠覆、神圣/堕落,以及自由/压迫六个维度。总分是 0–100 量表上的平均值。
有一道实际的题目会问:在养育孩子的过程中,是让孩子最终变得善良而谦卑更好,还是成功却冷漠更好?这展示了陈述题目的长度形态。它只是一道示例题,不是正确答案表,也不是关于育儿的建议。
基础结果页只显示一个总分和百分比,不显示各个道德基础的维度分,也不显示分数区间。它不应该被称为 MFQ 分数,因为本站的改编与已发表的问卷不同。想了解得更细,可以看这篇道德测试结果解读指南。[2]
关于时间、费用和隐私,需要先确认什么
在使用任何工具之前,请查看当前的服务页面,了解完成说明、使用条件以及是否收费。
同时也要阅读适用的隐私说明。"教育用途"并不自动等于匿名;而一个博客在没有关于服务如何处理数据的证据之前,不该承诺保密。如果这些说明没能满足你的需要,你可以选择不提供可识别身份的信息,或者干脆不用这个工具。
判断这个工具是否匹配你的问题
用下面这张表来决定下一步。它没有评分对照表。
| 你的问题 | 道德测试可能的用处 | 它仍然无法提供的东西 |
|---|---|---|
| "我在伦理困境中会注意到什么?" | 帮你找出一个想深入讨论的答案 | 关于你品格的完整描述 |
| "我的核心价值观是什么?" | 为具体的例子提供一些措辞参考 | 一份最终的、普适的优先级排序 |
| "在这场冲突中我该怎么做?" | 提醒你注意一个可能被忽略的关切 | 事实、专业规则,或者那个决定本身 |
| "我可以信任这个人吗?" | 任何分数都不该替你来回答这个问题 | 关于对方真实行为与所处情境的证据 |
| "我为什么会感到痛苦?" | 先把品格评分放到一边 | 心理健康评估或治疗方案 |
设想一下,Devon 想知道拒绝一个请求是不是会显得自私。测验结果无法给出答案。Devon 完全可以换一种做法:把这个请求本身讲清楚,把已经作出的承诺摆出来,说明谁会承担代价,再列出其他可行的选择。一个工具或许能提供提示,但真正的推理仍然需要回到现实处境本身。
在日常使用中,你可以这样区分:"价值观"指某人看重的优先事项,"道德"指关于是非对错的看法。"伦理"既可以指对这些看法的推理,也可以指一套明文的规范。Ellemers 等人把对错行为当作道德的操作性定义;Schwartz 则把价值观描述为按相对重要性排序的目标 [6,7]。这有助于把"一个优先事项"和"关于如何行动的价值判断"区分开。
使用结果,但别让它成为你的身份
选一个答案,写一个与它相符的例子,再写一个让它变得复杂的例子。问问自己:你当时知道什么?哪一种关切起了作用?换一个人会怎么描述这件事?你可能会觉得这个问题有用,同时仍然对这个标签保持不确定。
如果之后你再次使用这个工具,仅仅分数变了,并不能说明你个人有了成长。请去比较具体的决定和具体的理由。那份核心价值观工作表提供了另一条路径,让你记录这些例子,而不必反复做测试。
参考文献
- Cushman F, Young L, Hauser M. 2006. The role of conscious reasoning and intuition in moral judgment: Testing three principles of harm. Psychological Science. doi: 10.1111/j.1467-9280.2006.01834.x.
- Graham J, et al. Mapping the moral domain. Journal of Personality and Social Psychology. 2011;101(2):366–385. doi: 10.1037/a0021847.
- Atari M, et al. Morality beyond the WEIRD: How the nomological network of morality varies across cultures. Journal of Personality and Social Psychology. 2023;125(5):1157–1188. doi: 10.1037/pspp0000470.
- Ni X, Burns N, Mak AS, et al. 2023. To kill or not to kill: A systematic literature review of high-stakes moral decision-making measures and their psychometric properties. Frontiers in Psychology. doi: 10.3389/fpsyg.2022.1063607.
- Kahane G. 2015. Sidetracked by trolleys: Why sacrificial moral dilemmas tell us little (or nothing) about utilitarian judgment. Social Neuroscience. doi: 10.1080/17470919.2015.1023400.
- Ellemers N et al. 2019. The psychology of morality: A review and analysis of empirical studies published from 1940 through 2017. Personality and Social Psychology Review. doi: 10.1177/1088868318811759.
- Schwartz SH. 2012. An Overview of the Schwartz Theory of Basic Values. Online Readings in Psychology and Culture. doi: 10.9707/2307-0919.1116.
从你真正想追问的问题开始
道德测试可以是开启一场关于价值观的对话的一种方式。选择它,是因为它的任务与你的问题相关,而不是因为某个分数承诺能揭示你的真实自我。如果你正面对一个具体的决定,那份价值观冲突决策工作表可以帮助你梳理事实与各种选项。
当问题涉及健康、法律或安全时,请寻求有资质的专业指导。如果存在紧迫危险或自伤风险,请联系当地紧急服务或危机支持。测验或 AI 生成的解释不是紧急评估。
关于道德测试的常见问题
什么是道德问题?
它问的是"应该怎么做,以及为什么",其中涉及相关的利益、责任或后果。一场有意义的讨论,应该先弄清楚真正面临的是什么选择、需要哪些信息,而不是立刻去评判一个人的人格。
我该怎么弄清自己秉持的道德准则?
从一个你做过的决定开始,描述你当时试图保护的关切,然后考虑一个反例。问卷可以引出一些问题,但你的理由和行动都需要具体的处境来说明。
什么是 Moral Sense Test?
在 Cushman 等人的研究中,它是一项在线的哈佛任务,要求参与者评判有害的假设行为或不作为 [1]。研究者把判断与给出的理由作了比较。它与本站的同意度问卷是两种不同的任务,而不是一张品格证书。